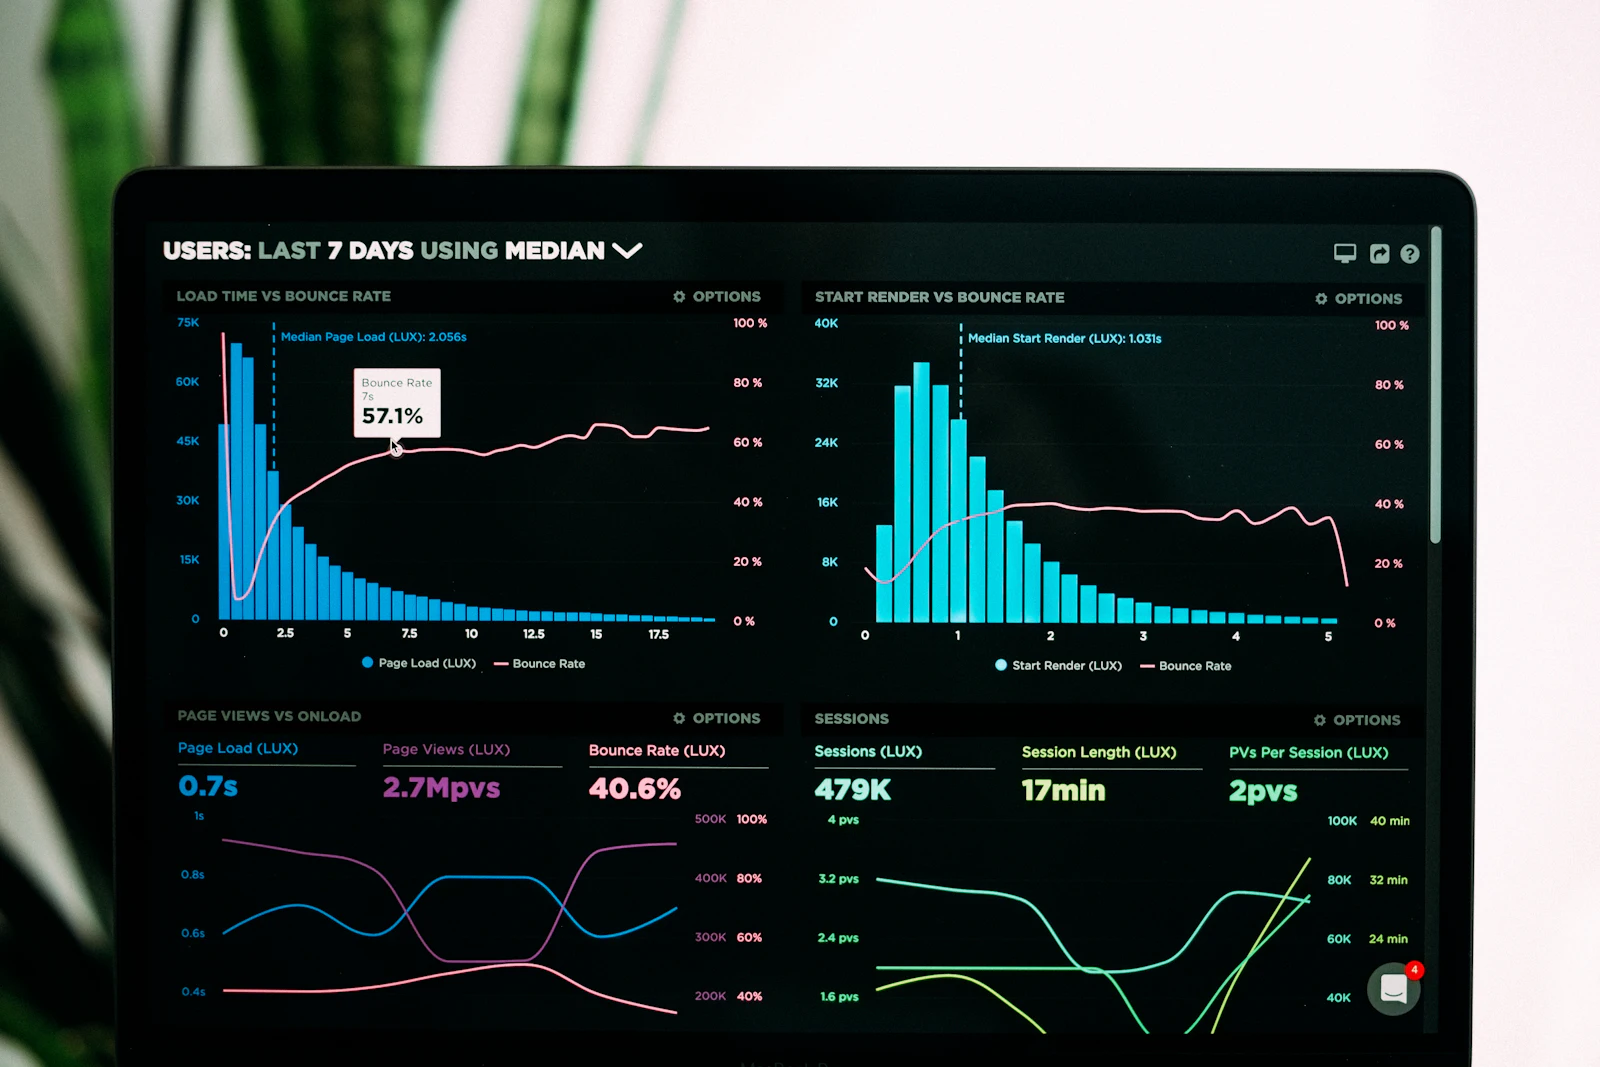
Налаштування моніторингу серверів і сервісів: метрики, логи, алерти
Налаштовуємо метрики, логи, дашборди й алерти для ваших серверів і сервісів. Алерти надходять у Telegram або Slack, і кожен пояснює, що зламалося й що робити. Мета — щоб про проблему ви дізнавалися з моніторингу, а не від користувача.
Коли це потрібно
- 1
Про збої ви дізнаєтеся від користувачів
- 2
Щоб знайти помилку, хтось мусить заходити на сервери по SSH і шукати в логах через grep
- 3
Алерти є, але їх так багато, що всі вимкнули сповіщення
- 4
Диск заповнився або сертифікат прострочився, і ніхто цього не передбачив
- 5
Реліз вийшов, і ніхто не може сказати, чи стало повільніше
Що входить
Метрики
Prometheus або VictoriaMetrics збирає метрики із серверів, Kubernetes, баз даних і черг. Ваші застосунки теж опитуємо, якщо вони віддають метрики; якщо ні — допомагаємо їх додати.
Логи
Grafana Alloy доставляє логи із серверів і контейнерів у Loki. Шукати в логах можна в Grafana поруч із метриками, а термін зберігання ви обираєте самі.
Дашборди
Дашборди Grafana під ваші сервіси: кількість запитів, помилки, затримка, довжина черги, використання ресурсів. Зберігаються як JSON у репозиторії, а не складаються руками в інтерфейсі.
Алерти
Правила для симптомів, які відчувають користувачі, — помилки, затримка, недоступність — і для причин, які можна передбачити: заповнення диска, пам'ять, сертифікати, що спливають. Alertmanager надсилає їх у Telegram, Slack або на пошту.
Перевірки доступності
Публічні адреси перевіряються ззовні вашої інфраструктури, тож збій буде помічено, навіть якщо сервер моніторингу впав разом з усім іншим.
Ранбуки
Кожен алерт веде на коротку інструкцію: що він означає, куди дивитися, що робити насамперед. Черговому не доводиться вгадувати.
Уся система на одному екрані
Стан сервісів, трафік, деплої та алерти — такі дашборди ми налаштовуємо для кожного проєкту.
Service overview
- Services
- 12
- Healthy
- 12 / 12
- Deploys today
- 7
- Open alerts
- 0
Requests per second
All services, 5 min average
p95 latency, ms
Alarm threshold 250 ms
Service health
| Service | Status | Pods | CPU |
|---|---|---|---|
| api-gateway | Healthy | 6 / 6 | 41% |
| billing | Healthy | 3 / 3 | 28% |
| worker-pool | Healthy | 9 / 9 | 63% |
| postgres-main | Healthy | 2 / 2 | 35% |
Recent deploys
- api-gatewayv2.14.112 min ago
- worker-poolv1.9.01 h ago
- billingv3.2.43 h ago
Ілюстрація з умовними даними. Для кожного проєкту дашборди будуємо під його власні сервіси.
Як іде робота
- 1
Дзвінок і доступи
Ви розповідаєте, що працює і які збої найболючіші. Ми дивимось, що вже збирається.
- 2
План і ціна
Що вимірюємо, які алерти потрібні й куди вони йдуть, скільки зберігаються дані. Обсяг і ціну фіксуємо до початку робіт.
- 3
Розгортання й налагодження
Стек встановлюється з коду. Потім узгоджений час спостерігаємо за алертами й прибираємо шумні, щоб кожен, який залишився, вимагав дії.
- 4
Передача або підтримка
Ви отримуєте дашборди, правила й ранбуки у своєму репозиторії. За договором підтримки ми ще й самі реагуємо на алерти.
Запитання
- Prometheus
- VictoriaMetrics
- Grafana
- Loki
- Grafana Alloy
- Alertmanager
- Blackbox Exporter
- node_exporter
- kube-state-metrics
- Telegram
- Slack
Опишіть завдання — отримайте план і ціну
Напишіть, що у вас є і що потрібно. Відповідаємо протягом одного робочого дня — запитаннями або конкретною пропозицією.